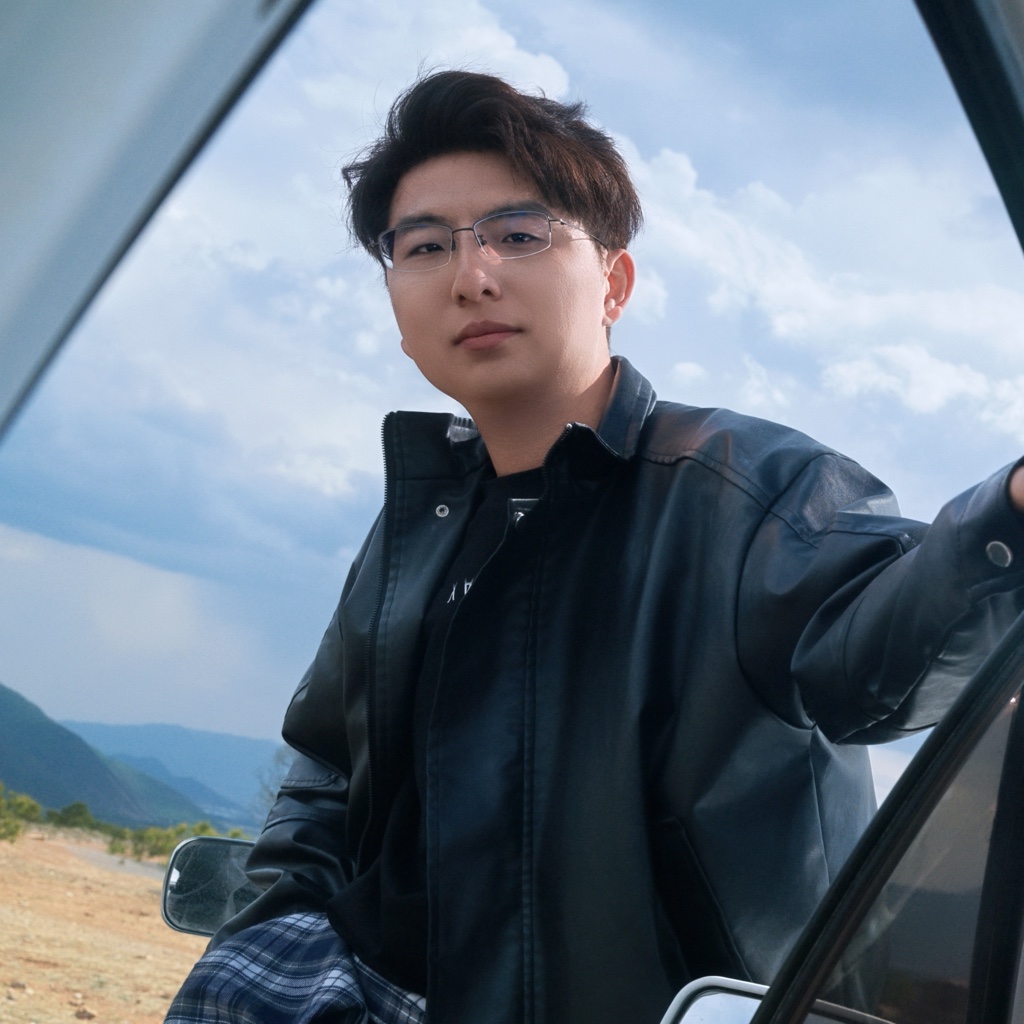
知识问答效果不好时,团队第一反应通常是换 embedding、调 top-k 或升级模型。我在数据平台场景里遇到的更多情况是:被索引的元数据本身不完整、没有版本,甚至彼此冲突。检索与生成只能重新排列现有信息,不能凭空修复事实链。
RAG 的上限取决于它能拿到什么证据。表名和描述只是最薄的一层;对象身份、来源、有效时间、负责人、血缘、权限和采集状态,决定答案能否从“听起来合理”走到“可以复核”。
邓明瑞 / 纯粹
知识问答效果不好时,团队第一反应通常是换 embedding、调 top-k 或升级模型。我在数据平台场景里遇到的更多情况是:被索引的元数据本身不完整、没有版本,甚至彼此冲突。检索与生成只能重新排列现有信息,不能凭空修复事实链。
RAG 的上限取决于它能拿到什么证据。表名和描述只是最薄的一层;对象身份、来源、有效时间、负责人、血缘、权限和采集状态,决定答案能否从“听起来合理”走到“可以复核”。
数据 Catalog 常见的问题不是没有资产,而是用户不知道该怎么找。平台要求先选实体类型,再填库、表、标签、负责人,只有熟悉元数据模型的人才能用好。自然语言适合作为入口,但它不该绕开 Catalog,直接让模型根据一堆描述猜表。
我的设计是两段式:模型把问题解析成结构化检索意图,Catalog 用确定性查询返回实体;模型再基于实体和关系组织答案。对象身份、权限和血缘事实仍由 Catalog 决定。
做 RAG 时,第一个容易陷进去的参数是 chunk_size。500 字还是 1000 字、overlap 取 50 还是 100,大家常凭几个问答效果争论。这个讨论缺少一个前提:我们希望每个 chunk 保住什么证据。
我不会先从字数出发,而是整理真实问题,为每个问题标注“最小充分证据”。切块策略能让这些证据稳定被召回,条件和结论没有被拆散,同时不带进大段无关内容,才算有效。
把大模型接进数据平台时,我不建议第一版就让它“自动完成数据操作”。企业数据查询本身已经包含权限、成本和口径风险;再开放 INSERT、DDL 或任务发布,错误会从一条答案扩散到真实系统状态。
第一版更合适的目标是只读数据助手:根据用户权限理解问题,生成候选查询,在受控环境执行,并把 SQL、结果依据和限制交给人复核。这里的“只读”不是 Prompt 里写一句“禁止修改”,而是从身份、解析、数据库权限到运行资源的多层约束。
把文档切块、算 embedding、写进向量索引,再接一个生成模型,几天就能搭出知识问答 Demo。这个 Demo 会让人产生一个错觉:只要相似度搜得准,企业知识库就建成了。实际运行一段时间后,问题往往不在向量库,而在知识从哪里来、何时失效、谁能看、答案引用了什么。
我把向量检索当成候选召回器。它回答的是“哪些片段在表示空间里接近这个问题”,不负责证明片段仍然有效,也不负责解决权限、冲突和业务口径。知识库是包含摄取、治理、检索、生成和反馈的一整条链路。
NL2SQL 演示很容易做出效果:准备几张表,把 schema 放进上下文,模型很快能生成一条能跑的 SQL。真正接到企业数据平台后,问题不再是“有没有 SQL”,而是这条 SQL 为什么可信。字段名写对、语法能执行,只通过了最浅的一层检查。
我把 NL2SQL 的交付物定义为“可验证查询”,不是一段字符串。除了 SQL,还要带上所用口径、对象版本、权限范围、执行计划风险和结果断言。模型负责提出候选,平台负责决定它是否有资格执行和回答。
数据平台接入 Spark、Flink 和 YARN 指标后,通常很快会建出一张“统一监控大盘”。最常见的统一方式,是把包含 CPU 的字段都改名为 cpu_usage,包含 records 的都改成 throughput。图表变整齐了,数值却失去原义:一个是累计 CPU 时间,一个是滑动窗口忙碌时长,另一个甚至只是调度器分配的 vcore-seconds。
我做跨引擎可观测时,不追求让所有指标长得一样。先保存原始指标和完整语义,再挑出真正可比较的业务事实。统一名字只能解决查询方便,统一口径才可能支撑诊断。
调度页面上最容易被低估的是“状态”这一列。很多系统只存等待、运行、成功、失败四个值,再由调度器、执行器、回调接口和人工操作一起修改。刚上线时看不出问题;一旦消息延迟、worker 重启或用户点了重跑,同一个实例会在几秒内来回变色,最后状态与实际进程各说各话。
我设计实例状态机时,先问三个问题:谁有权写这个状态,凭什么证据迁移,迟到事件还能不能改变结论。状态不是 UI 文案,而是控制依赖、重试、资源回收和告警的业务协议。