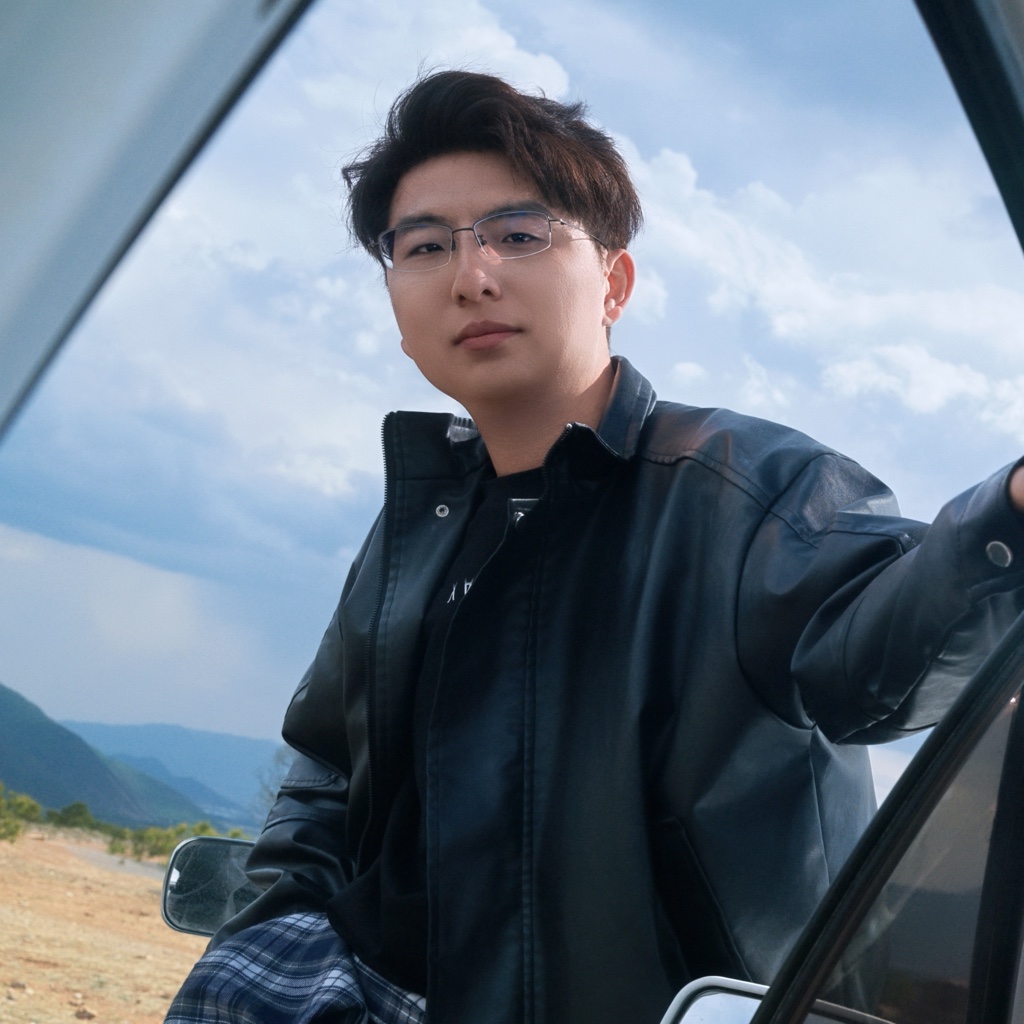
OpenAI 的 Dots 文档里有一条很容易漏掉:按下 Pause,只会停掉 Dot 当前的主任务。它已经委派出去的后台任务可能还在跑,未来的 Schedule 也不会自动取消。已经发出的消息更不会收回来。
这个细节比“常驻 Agent”四个字更能说明 Dots 是什么。它接手的不是一次对话,而是一项持续责任;责任下面会长出主任务、后台任务和计划任务。启动很简单,停干净反而要理解这三层状态。
邓明瑞 / 纯粹
OpenAI 的 Dots 文档里有一条很容易漏掉:按下 Pause,只会停掉 Dot 当前的主任务。它已经委派出去的后台任务可能还在跑,未来的 Schedule 也不会自动取消。已经发出的消息更不会收回来。
这个细节比“常驻 Agent”四个字更能说明 Dots 是什么。它接手的不是一次对话,而是一项持续责任;责任下面会长出主任务、后台任务和计划任务。启动很简单,停干净反而要理解这三层状态。
Grok Bot 的发布页很会抓人:一支常驻 Agent 团队,各自有电脑,会互相发消息,还能 24 小时干活。看到这里,我脑子里冒出的却是一个很扫兴的问题:东西呢?
八个 Bot 在群聊里分工、复述进度,看起来很忙。页面没做出来、文件找不到、外部动作没人敢确认,这支“团队”仍然只是八个聊天窗口。Grok Bot 值得看的地方,是它把多 Agent 协作接到了云电脑、应用和 Routine;也正因为接了出去,所有权和权限问题躲不过去了。
Meta 的 Muse 发布稿里有一句话让我停下来多看了几遍:每个用户会得到一台专属云电脑,Agent 和数据都住在里面。这比“个人 AI”具体得多。聊天窗口关掉了,浏览器、文件和登录会话还在,Muse 可以接着干活。
麻烦也从这里开始。一段回答写错了,关掉就行;一台拿着登录会话、半夜仍在运行的电脑做错事,后果已经落到外部网站。我想看的不是 Muse 会不会写计划,而是这台电脑如何留住现场、谁准它往外发东西,以及出问题时能不能查清楚。
数据平台里做一个“能回答任务为什么失败”的 Agent 不难:接入日志、元数据和模型,常见错误能说得像模像样。真正困难的是用户继续说“那你帮我修一下并重跑”,系统还能保持对象正确、权限清楚、执行幂等,并证明数据结果已经恢复。
我认为数据平台 Agent 的终点不是更自然的问答,而是可验证执行。自然语言意图要经过对象解析、证据诊断、变更计划、权限决定、受控操作和结果验收,最终每一步都能回到真实系统核对。
长任务超过上下文窗口后,把前半段对话总结成几段文字再继续,是最直接的压缩方法。它也最容易丢掉关键东西:用户说“不要提交”,摘要只保留了“修改配置”;工具状态仍未知,却被写成“部署失败”;一个尚未回答的问题从列表中消失。
上下文压缩不是文学摘要。它要把后续执行所需的约束和状态,从大量过程文本迁移到更小、可验证的运行表示。哪些可以概括,哪些必须原样保留,应该由信息职责决定,而不是按 token 比例截取。
把一个任务拆给多个 Agent,吞吐量看起来会立刻提升。真正跑到共享仓库、文档或业务系统时,问题也随之出现:两个 Agent 同时改同一文件,研究 Agent 更新了结论,写作 Agent 还在引用旧证据,两个执行 Agent 重复提交同一工单。
多 Agent 首先是并发系统,其次才是角色设计。分工名称并不会自动提供隔离、一致性和幂等。共享状态必须有 owner、版本和合并语义,外部副作用必须回到单一的授权与提交边界。
一个熟练工程师排查问题时,会自然地区分日志事实和猜测,先查对象再执行危险命令,修改后做回归。这些习惯平时藏在脑子里。把它们交给 Agent,如果只写“你是一名资深专家,请谨慎处理”,真正的边界一个都没留下。
Skill 的价值不是增加人设,而是把某一类任务的触发条件、操作顺序、证据标准、危险边界和验收方式写成可复用协议。它应该比大段系统提示更窄,也更容易评审和测试。
“代码在容器里运行,所以是隔离的”这句话信息量很低。容器挂了哪些目录、能访问哪些网段、使用谁的云凭证、能否启动特权子进程、输出会被送到哪里,任何一项没说清,隔离都可能只是一层包装。
执行型 Agent 会读取仓库、安装依赖、运行命令、访问网站和调用工具。它的能力集合应该像部署规格一样被声明、审批和验证。我把这份契约叫 Sandbox Manifest:不是给人看的安全口号,而是运行时真正执行的清单。
“模型没有返回结果”是一句症状,不是根因。我见过模型已经正常结束,网关漏了 terminal event;也见过前端展示了答案,服务端却没有持久化。只看其中一层,谁都能拿出一段日志证明自己没问题。
Agent 诊断需要的是可连接、可校验的证据链。它从用户实际看见的结果出发,关联到 Run、上下文、模型 Attempt、工具 Operation、流事件和最终存储,并明确哪一段是原始事实、哪一段是系统推断。
把所有对话按用户 ID 存下来,再做 embedding,通常就被叫作“长期记忆”。这个方案演示很快,生产问题也来得快:用户改了偏好,旧片段仍被召回;一句推测被当成事实;删除账户后,向量索引里还残留副本。
Memory DB 不是消息归档的别名。它要管理记忆如何产生、依据什么、何时有效、与谁冲突、能否被检索、何时遗忘。原始经历、提炼事实和检索索引承担不同职责,不能混在一张 conversations 表里。
传统服务报错,值班同学通常先看接口、实例和依赖。Agent 出问题时,表面症状更混乱:用户说“一直转圈”,可能是模型仍在生成、工具卡住、SSE 丢了终态,也可能任务已经完成但结果没有持久化。
运行手册不能按团队组件来写成“模型篇、向量库篇、MCP 篇”。值班者首先拿到的是用户症状和一个时间点。我更愿意从结果状态出发,先确认影响与副作用,再沿 Run 的证据链定位归属。
一次 Agent 删除了错误的数据分区。事故复盘时,审计平台拿当前角色去查,结论是“没有删除权限”。这并不能证明当时的请求被拦截,也不能说明是谁授权的:角色、组织关系、策略和资源标签可能都已变化。
权限审计要回答的是历史问题:在那一刻,哪个主体代表谁,以什么目的,对哪个版本的资源发起了什么动作,策略根据哪些事实作出允许或拒绝。只存用户名和 HTTP 200,根本还原不了这条链。
1 / 5